Diagnostic des nœuds
Ouvrez verified_user Zone d’administration > build Système > monitor_heart État des services, puis la flèche à côté du nom d’un fournisseur ou d’un relais.
Ce que lit le diagnostic
Le diagnostic combine trois sources, dans cet ordre :
Les statistiques HAProxy : les points d’entrée, les nœuds servis par chacun et le port utilisé.
Chaque nœud, en direct : son moteur de conteneurs pour un cluster Swarm, son serveur d’API pour Kubernetes.
La liste des nœuds du cluster, demandée à un nœud dont les sondes viennent de confirmer la santé.
La troisième source n’est jamais demandée au répartiteur de charge. Celui-ci répartit les appels sur les machines qu’il dessert : un appel sur trois arriverait sur la machine en panne. Reemo interroge donc directement un nœud sain.
Le port des stats
Reemo lit les statistiques en HTTP, sur l’hôte du cluster, port 8404 par défaut. Pour un autre port, renseignez le champ HAProxy stats port de la fiche du relais ou de la configuration du cluster. Chaque cluster garde ainsi sa propre valeur.
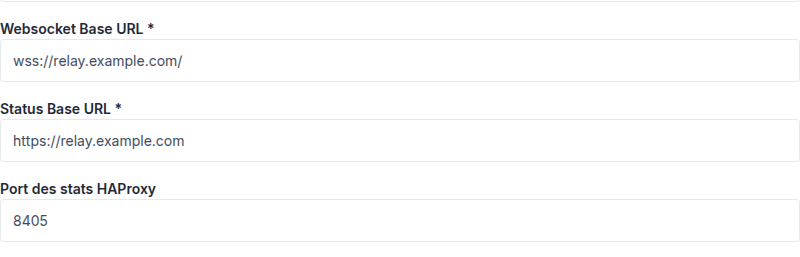
Sur un relais websocket, dans verified_user Zone d’administration > shield Réseau & Sécurité > settings_ethernet Relais Websocket
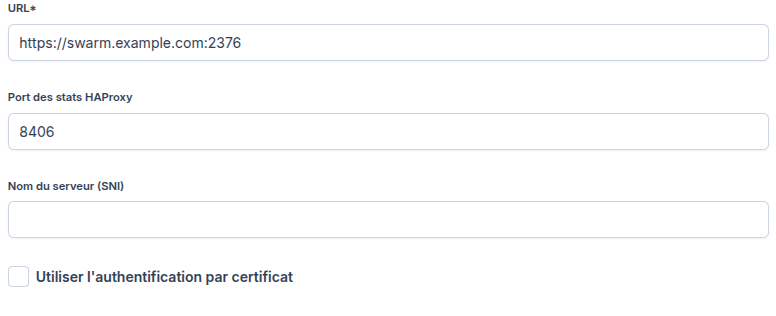
Sur un fournisseur de conteneurs, dans verified_user Zone d’administration > view_in_ar Conteneurs & Stations de travail > dns Fournisseurs de conteneurs, sous Configurations de cluster
Une page de statistiques ouverte au niveau de privilège le plus bas suffit. N’accordez pas le niveau administrateur : il autorise aussi à activer et désactiver des serveurs. HAProxy réserve à ce niveau l’adresse de chaque serveur, mais Reemo nomme ses serveurs d’après l’adresse qu’ils servent et la retrouve dans ce nom.
Note
Laissez le champ vide si HAProxy publie ses statistiques sur 8404. Une valeur hors de la plage 1-65535 est ignorée, et le port par défaut s’applique.
Relais et fournisseurs de conteneurs
Un relais websocket doit se trouver derrière un répartiteur de charge : c’est ainsi qu’un client l’atteint. Des statistiques illisibles constituent donc une anomalie, et aucun nœud ne peut être rapporté.
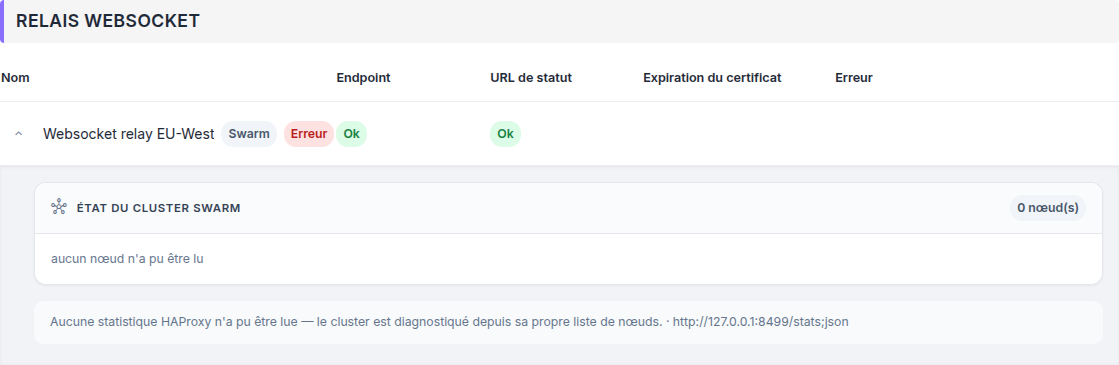
Un relais dont les statistiques n’ont pas pu être lues : le verdict est Erreur et aucun nœud n’est listé
Un fournisseur de conteneurs peut n’avoir rien devant lui. Ses statistiques sont lues au mieux : faute d’inventaire, le diagnostic utilise la liste de nœuds du cluster et l’indique sous le tableau.
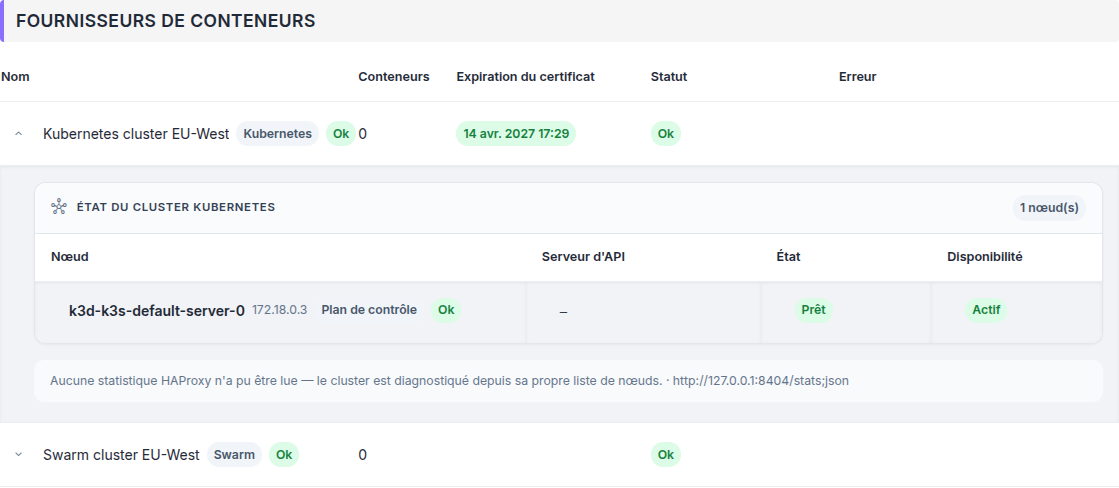
Un cluster Kubernetes sans répartiteur de charge devant lui, diagnostiqué depuis sa propre liste de nœuds
Le tableau des nœuds
La première carte du panneau liste les nœuds. Ses colonnes dépendent du type de cluster.
Colonnes d’un cluster Swarm
Colonne |
Contenu |
|---|---|
Nœud |
Nom d’hôte, adresse, rôle et état, plus un avertissement si le nœud est hors du pool du répartiteur de charge. |
Moteur |
Version du moteur de conteneurs annoncée par le nœud. |
Swarm |
Le moteur a un swarm actif, ou non. |
État |
État que le cluster donne à ce nœud. |
Disponibilité |
Le cluster y planifie du travail : Actif, Pause ou Drainer. |
Accessibilité |
Les autres managers joignent ce nœud, ou non. |
Colonnes d’un cluster Kubernetes
Colonne |
Contenu |
|---|---|
Nœud |
Nom d’hôte, adresse, rôle et état, plus le même avertissement sur le pool. |
Serveur d’API |
Le serveur d’API a répondu à cette adresse, et avec quel code. |
État |
Le cluster déclare le nœud prêt, ou non. |
Disponibilité |
Le cluster y planifie du travail. |
Un tiret signale une valeur non lue. Un nœud Kubernetes n’est sondé à sa propre adresse que si le répartiteur de charge le nomme, car il ne répond pas sur le port du serveur d’API. Son état de préparation vient alors de la liste de nœuds du cluster, et la colonne Serveur d’API affiche un tiret.
Le rôle détermine si un nœud doit être servi par le répartiteur de charge. Un Manager et un Plan de contrôle doivent l’être. Un Worker n’a pas à l’être : il porte un avertissement, sans que le verdict passe en erreur.
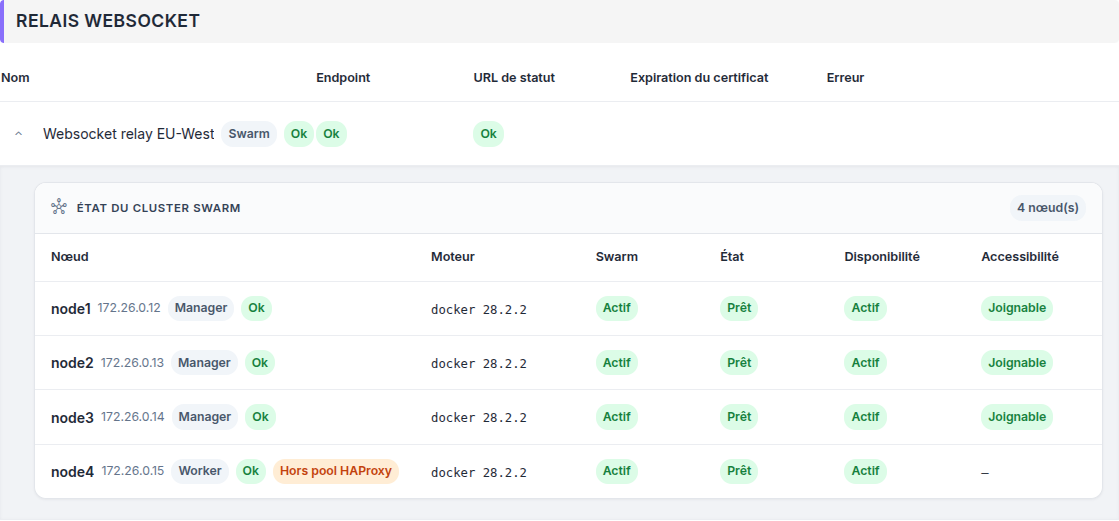
node4 est un worker : il est hors du pool, et c’est normal
États des nœuds
Le badge à côté du nom d’un nœud donne son état. Survolez-le pour lire le détail qui a conduit à cet état.
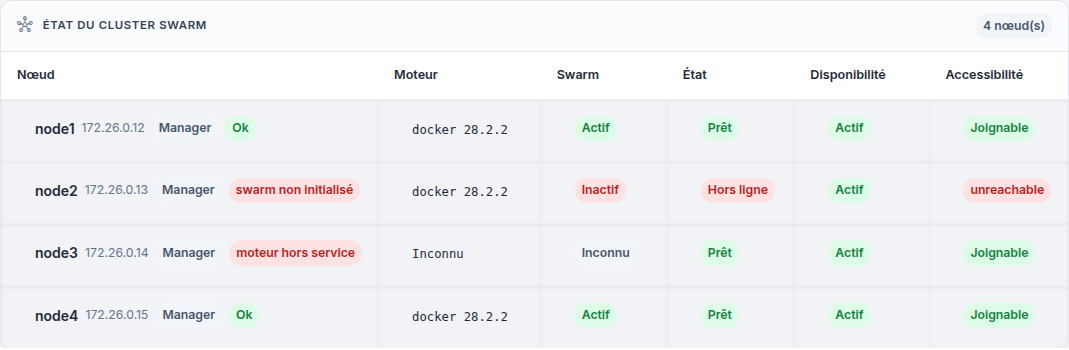
Trois états dans un même cluster : un moteur qui ne répond plus, un nœud qui a quitté le swarm, et deux nœuds sains
États d’un nœud Swarm
État |
Signification |
Où regarder |
|---|---|---|
Ok |
Le nœud répond et appartient au cluster ; le répartiteur de charge le sert conformément à son rôle. |
Rien à faire. |
nginx injoignable |
Rien n’a répondu à l’adresse du nœud. |
La machine, ou le proxy de socket devant son moteur. |
moteur hors service |
Le proxy de socket répond, mais le moteur derrière lui renvoie une erreur serveur. |
Le moteur de conteneurs sur cette machine. |
swarm non initialisé |
Le moteur répond mais ne fait partie d’aucun swarm. |
Le nœud a quitté le cluster, ou n’y a jamais été joint. |
hors du cluster |
Le moteur appartient à un autre cluster, ou ce cluster ne liste pas le nœud. |
Un nœud joint au mauvais cluster, ou une entrée restée dans le répartiteur de charge. |
non servi par le proxy |
Aucun point d’entrée ne sert ce nœud, alors que son rôle l’exige. |
La configuration du répartiteur de charge. |
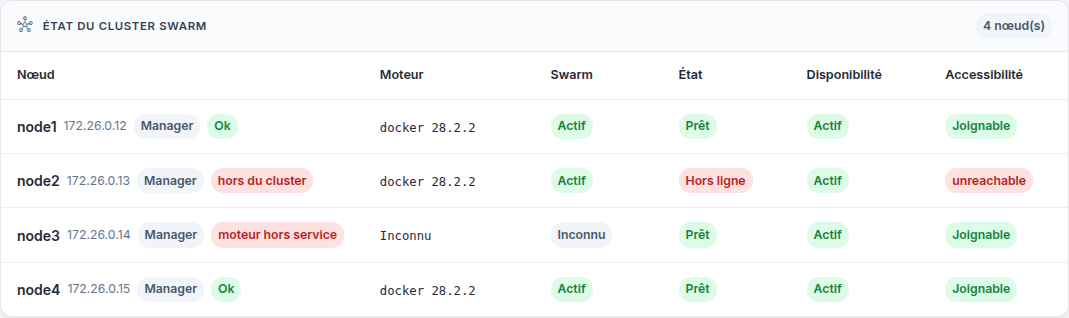
node2 répond, mais son moteur a été joint à un autre cluster
États d’un nœud Kubernetes
État |
Signification |
Où regarder |
|---|---|---|
Ok |
Le nœud est listé comme prêt ; le répartiteur de charge le sert conformément à son rôle. |
Rien à faire. |
injoignable |
Rien n’a répondu à l’adresse annoncée par le répartiteur de charge. |
La machine, ou le point d’entrée qui la précède. |
serveur d’API hors service |
Le serveur d’API renvoie une erreur serveur. |
Le plan de contrôle sur cette machine. |
pas prêt |
Le cluster déclare le nœud non prêt. |
Le kubelet et les conditions propres au nœud. |
hors du cluster |
Le cluster ne liste pas ce nœud. |
Une entrée restée dans le répartiteur de charge. |
non servi par le proxy |
Aucun point d’entrée ne sert ce nœud de plan de contrôle. |
La configuration du répartiteur de charge. |
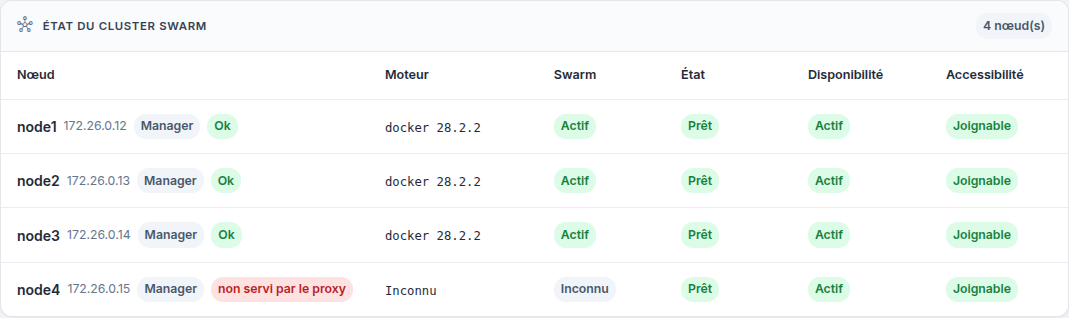
node4 a été promu manager, et aucun point d’entrée n’a jamais été ajouté pour lui
Certains états sont propres à un type de cluster : nginx injoignable, moteur hors service et swarm non initialisé n’existent que pour Swarm ; injoignable, serveur d’API hors service et pas prêt seulement pour Kubernetes.
L’état non servi par le proxy dépend aussi de la famille. Un relais websocket le signale dès qu’un manager manque dans le répartiteur de charge, puisque c’est la seule voie pour l’atteindre. Un fournisseur de conteneurs sur un cluster Swarm sonde les machines que le cluster nomme, même si le répartiteur les ignore : un manager qui répond s’affiche donc Ok. Sur un cluster Kubernetes, où un nœud ne peut pas être sondé à sa propre adresse, l’inventaire du répartiteur redevient le seul indice et l’état s’applique.
Le verdict du cluster
Le badge à côté du nom du cluster résume ses nœuds :
Erreur : un nœud censé porter du trafic ne le fait pas, ou la liste des nœuds du cluster n’a pas pu être lue.
Avertissement : un nœud dont on n’attend pas de trafic est dans un état inattendu, ou un nœud n’est servi que par une partie des pools auxquels il appartient.
Ok : aucun des cas ci-dessus.
non disponible : le diagnostic n’a pas pu être exécuté. L’appliance qui porte le cluster est hors ligne, ou le service qui réalise le diagnostic n’a pas encore été mis à jour.
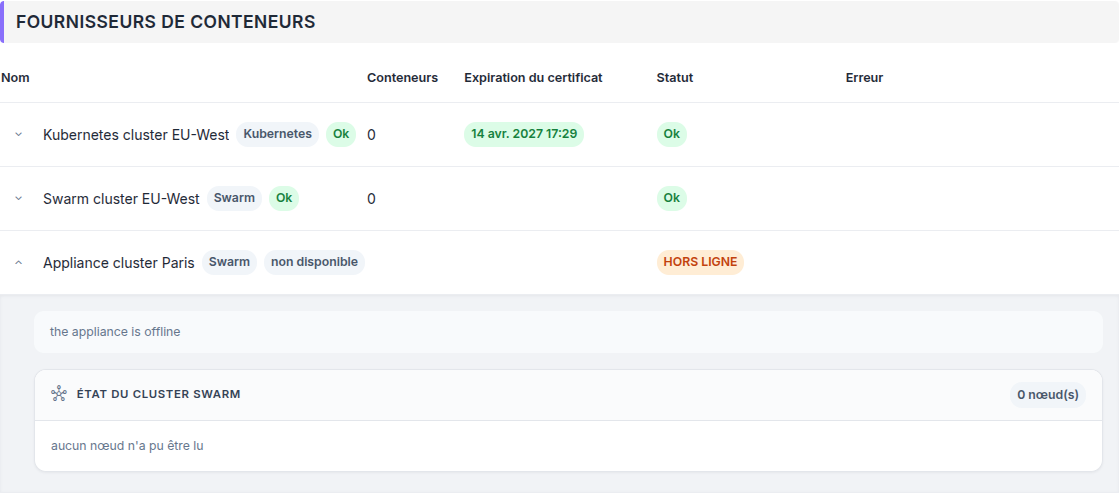
Une appliance hors ligne : le diagnostic n’est pas disponible, et aucune conclusion n’est tirée
Un nœud servi par certains points d’entrée mais absent des autres mérite une attention particulière. Sur la capture ci-dessous, chaque nœud affiche Ok et le verdict affiche Avertissement : node4 est un manager, il apparaît dans son propre point d’entrée, et il est absent des trois pools que ses pairs partagent. Aucun trafic ne lui parvient.
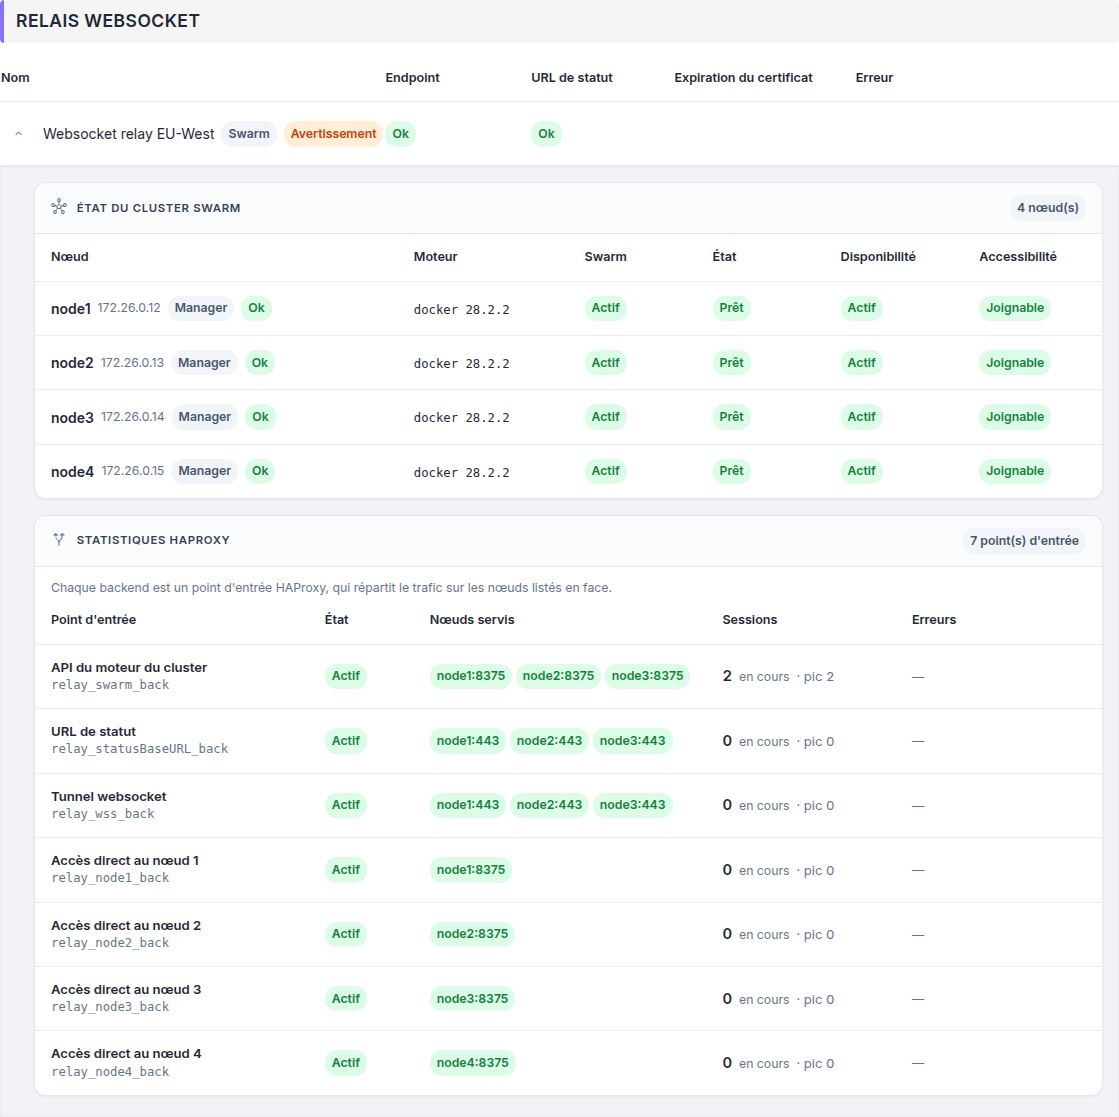
Un nœud branché sur une partie seulement du répartiteur de charge
Note
Un point d’entrée qui ne sert qu’un seul nœud donne un accès direct à ce nœud. Ce n’est pas un pool, et il n’entre pas dans ce calcul.
Quand la liste des nœuds du cluster ne peut pas être lue, chaque nœud garde l’état que sa propre sonde lui a valu et le cluster affiche Erreur : sans cette liste, l’appartenance et les rôles restent inconnus, et aucun nœud ne peut être déclaré sain.
Les statistiques HAProxy
La seconde carte du panneau rapporte le répartiteur de charge, une ligne par point d’entrée.
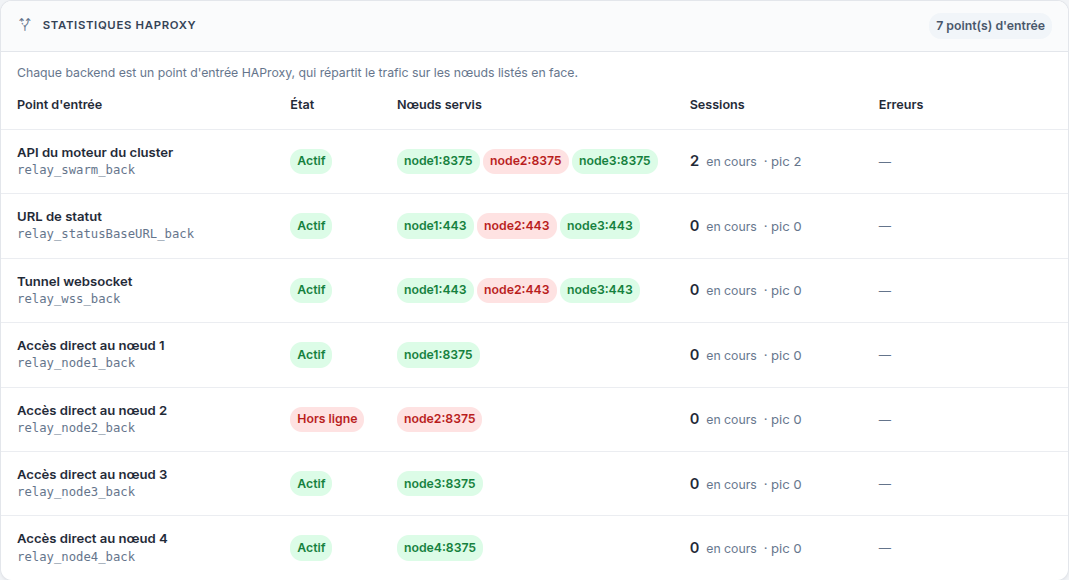
Les points d’entrée d’un relais, un nœud étant hors service
Colonne |
Contenu |
|---|---|
Point d’entrée |
Le rôle déduit du nom du backend, avec le nom brut en dessous. Ce rôle est une lecture de la convention de nommage : vérifiez-le sur le nom brut. |
État |
L’état que HAProxy donne à ce point d’entrée dans son ensemble. |
Nœuds servis |
Les nœuds sur lesquels il répartit, avec le port utilisé. En rouge, un nœud que HAProxy a sorti du pool. |
Sessions |
Les connexions ouvertes en ce moment, et le plus haut niveau atteint depuis le démarrage d’HAProxy. |
Erreurs |
Les connexions échouées vers un nœud, les réponses invalides et les connexions retentées ailleurs. |
Warning
Les compteurs d’Erreurs sont cumulés depuis le démarrage d’HAProxy et ne sont jamais remis à zéro. Un chiffre ne signifie donc pas qu’un incident est en cours, et un tiret signifie qu’aucun compteur n’a bougé depuis ce démarrage. Comparez-les au pic de Sessions pour les interpréter.
Par où commencer
Un nœud en erreur alors que le point d’entrée répond signifie que le service a survécu sur les machines restantes. Dans l’ordre :
Lisez l’état du nœud et son infobulle : ils nomment la couche qui a échoué.
Vérifiez ce nœud dans la colonne Nœuds servis. Si HAProxy l’a sorti du pool, le trafic l’évite déjà.
Réparez la couche concernée, puis cliquez sur Actualiser : le diagnostic est repris de zéro.
See also
État des services — la page depuis laquelle ces diagnostics s’ouvrent.